Cuando una empresa gestiona sus incidentes por correo electrónico, hoja de cálculo compartida o canal de mensajería informal, el tiempo de resolución depende menos de la gravedad del problema que de la capacidad de alguien para encontrar al interlocutor adecuado. La gestión de incidentes en la empresa se basa en una secuencia precisa: declaración, clasificación, escalado, resolución y revisión. Cada eslabón que falta alarga la interrupción del servicio y multiplica los riesgos de recurrencia.
Rastreo regulatorio y notificación: lo que NIS2 cambia para la gestión de incidentes
La directiva europea NIS2, aplicable desde el 18 de octubre de 2024, impone a las empresas afectadas medidas de gestión de riesgos, obligaciones de notificación de incidentes y un papel explícito del órgano de dirección en la supervisión de estos procesos. Este marco ya no se refiere únicamente a los operadores de infraestructuras críticas: se extiende a un ámbito mucho más amplio de sectores y tamaños de empresas.
En Italia, la transposición de NIS2 ha dado lugar a requisitos muy operativos en los planes de respuesta y las notificaciones, con una actualización regulatoria publicada en septiembre de 2025 y que entrará en vigor en enero de 2026. Esta granularidad regulatoria ilustra una tendencia de fondo: los flujos de trabajo de incidentes deben integrar rastreo y validación gerencial para seguir siendo conformes.
Para las empresas francesas, esto significa concretamente que una herramienta de gestión de incidentes debe poder fechar cada acción, conservar las pruebas asociadas y generar un historial auditable. Una simple hoja de Excel no cumple ninguna de estas condiciones. Las plataformas especializadas como la propuesta en irist.fr estructuran nativamente estas obligaciones en sus flujos de trabajo, lo que reduce el riesgo de incumplimiento durante un control.
Gestión de incidentes y respuesta a incidentes: dos ámbitos que no deben confundirse
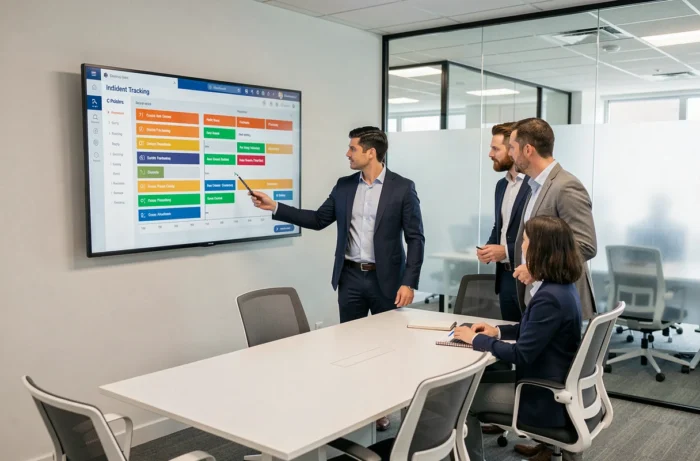
El mercado ahora distingue más claramente estas dos nociones. La respuesta a incidentes cubre la acción en tiempo real: detectar, contener, resolver. La gestión de incidentes, por su parte, abarca un ámbito más amplio que incluye la recepción, la clasificación, el escalado, el seguimiento y la revisión posterior.
| Criterio | Respuesta a incidentes | Gestión de incidentes (de extremo a extremo) |
|---|---|---|
| Ámbito temporal | Detección hasta resolución | Declaración hasta revisión post-incidente |
| Actores principales | Equipos técnicos (Ops, SRE, SOC) | Equipos técnicos + gestión + QHSE |
| Objetivo prioritario | Reducir el tiempo de indisponibilidad | Reducir la recurrencia y asegurar la conformidad |
| Rastreo exigido | Registros técnicos | Historial completo con validación jerárquica |
| Post-mortem | Opcional según la criticidad | Sistemático, con plan de acciones correctivas |
Confundir los dos conduce a menudo a elegir una herramienta de alerta pura (tipo PagerDuty u Opsgenie) donde la empresa necesita una plataforma ITSM que cubra el ciclo completo. Por el contrario, una PYME cuyos incidentes son raros y técnicos no necesita un flujo de trabajo QHSE completo con aprobación en tres niveles.
El error frecuente: apilar herramientas sin orquestación
Una herramienta de ticketing para IT, un formulario para la seguridad en el trabajo, un canal de Slack para emergencias: esta fragmentación crea ángulos muertos. Los incidentes menores, demasiado triviales para justificar la apertura de un ticket formal, pasan desapercibidos. Sin embargo, son precisamente estos micro-dysfuncionamientos repetidos los que terminan provocando interrupciones mayores.
Centralizar la declaración en un punto de entrada único reduce la fricción para los colaboradores. Cuando reportar un problema toma menos de treinta segundos en un smartphone, la tasa de reporte aumenta significativamente, y los datos recolectados se vuelven utilizables para el análisis de causas raíz.
Automatización del triage y orquestación por IA: la evolución reciente del software de gestión de incidentes
Las herramientas de gestión de incidentes han evolucionado más allá del simple ticketing. La tendencia actual se centra en la IA operativa aplicada al triage, la coordinación y los informes post-incidente. Las plataformas recientes no solo abren un ticket: categorizan automáticamente el incidente, identifican al equipo competente y desencadenan el flujo de trabajo de escalado adecuado.
Este nivel de automatización responde a un problema concreto. Según los datos del corpus de la competencia, un equipo de IT promedio dedica aproximadamente un tercio de su tiempo a gestionar incidentes e interrupciones. La automatización del triage libera una parte significativa de este tiempo para tareas de mayor valor añadido.
Tres capacidades diferencian las soluciones actuales de las generaciones anteriores:
- La clasificación automática mediante análisis del texto de la declaración, que asigna una prioridad y un dominio (IT, seguridad, mantenimiento) sin intervención humana.
- La orquestación de los intervinientes con notificación dirigida según reglas predefinidas, incluida la gestión de guardias y reemplazos.
- La generación asistida del informe post-incidente, que sintetiza la cronología, las acciones realizadas y las recomendaciones a partir de los datos del ticket.
Criterios de elección de un software de gestión de incidentes adecuado para su empresa
La elección de una solución depende menos del número de funcionalidades mostradas que de la adecuación con el proceso real de la empresa. Una herramienta sobreconfigurada que nadie utiliza cuesta más que una herramienta simple adoptada por todos.
- La facilidad de declaración para los no técnicos: si el formulario requiere más de dos minutos, la tasa de reporte cae. El acceso móvil es un requisito previo, no un bono.
- La cobertura del ciclo completo: desde la declaración hasta la revisión post-incidente, pasando por el escalado y el seguimiento de las acciones correctivas. Una herramienta que se detiene en el cierre del ticket deja un ángulo muerto en la prevención.
- La integración con las herramientas existentes (mensajería, SIRH, supervisión técnica): cada reingreso manual es una fuente de error y pérdida de tiempo.
- La conformidad regulatoria nativa: sellado de tiempo, pista de auditoría, conservación de pruebas. Estas funciones deben estar integradas por defecto, no añadidas como una capa adicional.
QHSE e IT: necesidades convergentes
Los equipos de QHSE (calidad, higiene, seguridad, medio ambiente) y los equipos de IT comparten una necesidad idéntica: transformar cada incidente en dato explotable para reducir la recurrencia. La diferencia radica en el vocabulario y los marcos de referencia. Un buen software de gestión de incidentes ofrece plantillas de formularios adaptadas a cada ámbito mientras alimenta un marco de referencia común de análisis.
La convergencia entre estos dos mundos se acelera por las exigencias de NIS2 y las normas ISO. Las empresas que aún gestionan sus incidentes de QHSE en papel y sus incidentes de IT en Jira pierden la visión transversal necesaria para identificar problemas sistémicos. Un marco de referencia único de incidentes mejora la detección de las causas raíz compartidas entre ámbitos, como un defecto de mantenimiento que genera tanto un incidente de seguridad física como una falla de equipo conectado.