Quand une entreprise gère ses incidents par email, tableur partagé ou canal de messagerie informel, le temps de résolution dépend moins de la gravité du problème que de la capacité de quelqu’un à trouver le bon interlocuteur. La gestion des incidents en entreprise repose sur un enchaînement précis : déclaration, classification, escalade, résolution, puis revue. Chaque maillon manquant allonge l’interruption de service et multiplie les risques de récurrence.
Traçabilité réglementaire et notification : ce que NIS2 change pour la gestion des incidents
La directive européenne NIS2, applicable depuis le 18 octobre 2024, impose aux entreprises concernées des mesures de gestion des risques, des obligations de notification d’incidents et un rôle explicite de l’organe de direction dans la supervision de ces processus. Ce cadre ne concerne plus uniquement les opérateurs d’infrastructures critiques : il s’étend à un périmètre bien plus large de secteurs et de tailles d’entreprises.
En Italie, la transposition de NIS2 a donné lieu à des exigences très opérationnelles sur les plans de réponse et les notifications, avec une mise à jour réglementaire publiée en septembre 2025 et entrée en vigueur en janvier 2026. Cette granularité réglementaire illustre une tendance de fond : les workflows d’incident doivent intégrer traçabilité et validation managériale pour rester conformes.
Pour les entreprises françaises, cela signifie concrètement qu’un outil de gestion des incidents doit pouvoir horodater chaque action, conserver les preuves associées et générer un historique auditable. Un simple tableau Excel ne remplit aucune de ces conditions. Les plateformes spécialisées comme celle proposée sur irist.fr structurent nativement ces obligations dans leurs flux de travail, ce qui réduit le risque de non-conformité lors d’un contrôle.
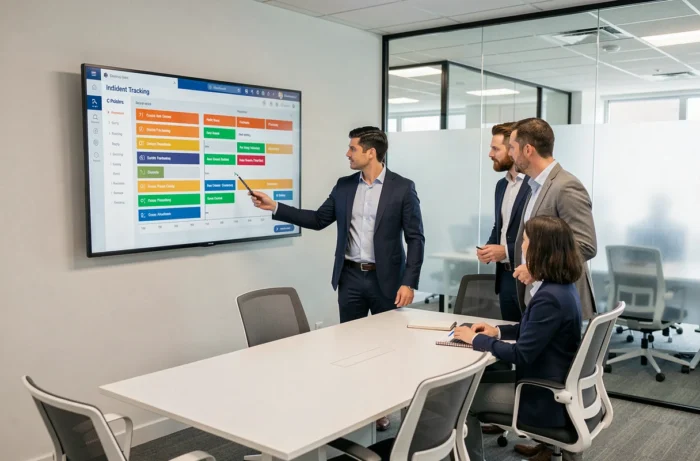
Gestion d’incident et réponse à incident : deux périmètres à ne pas confondre
Le marché distingue désormais plus nettement ces deux notions. La réponse à incident couvre l’action en temps réel : détecter, contenir, résoudre. La gestion d’incident, elle, englobe un périmètre plus large qui inclut l’intake, la classification, l’escalade, le suivi et la revue a posteriori.
| Critère | Réponse à incident | Gestion d’incident (bout en bout) |
|---|---|---|
| Périmètre temporel | Détection jusqu’à résolution | Déclaration jusqu’à revue post-incident |
| Acteurs principaux | Équipes techniques (Ops, SRE, SOC) | Équipes techniques + management + QHSE |
| Objectif prioritaire | Réduire le temps d’indisponibilité | Réduire la récurrence et assurer la conformité |
| Traçabilité exigée | Logs techniques | Historique complet avec validation hiérarchique |
| Post-mortem | Optionnel selon la criticité | Systématique, avec plan d’actions correctives |
Confondre les deux conduit souvent à choisir un outil d’alerting pur (type PagerDuty ou Opsgenie) là où l’entreprise a besoin d’une plateforme ITSM couvrant le cycle complet. À l’inverse, une PME dont les incidents sont rares et techniques n’a pas besoin d’un workflow QHSE complet avec approbation en trois niveaux.
L’erreur fréquente : empiler les outils sans orchestration
Un outil de ticketing pour l’IT, un formulaire pour la sécurité au travail, un canal Slack pour les urgences : cette fragmentation crée des angles morts. Les incidents mineurs, trop anodins pour justifier l’ouverture d’un ticket formel, passent sous les radars. Or ce sont précisément ces micro-dysfonctionnements répétés qui finissent par provoquer des interruptions majeures.
Centraliser la déclaration dans un point d’entrée unique réduit la friction pour les collaborateurs. Quand signaler un problème prend moins de trente secondes sur un smartphone, le taux de remontée augmente significativement, et les données collectées deviennent exploitables pour l’analyse des causes profondes.
Automatisation du triage et orchestration par l’IA : l’évolution récente des logiciels de gestion des incidents
Les outils de gestion des incidents ont évolué au-delà du simple ticketing. La tendance actuelle porte sur l’IA opérationnelle appliquée au triage, à la coordination et aux comptes rendus post-incident. Les plateformes récentes ne se contentent plus d’ouvrir un ticket : elles catégorisent automatiquement l’incident, identifient l’équipe compétente et déclenchent le workflow d’escalade adapté.
Ce niveau d’automatisation répond à un problème concret. Selon les données du corpus concurrent, une équipe IT moyenne consacre environ un tiers de son temps à gérer les incidents et interruptions. L’automatisation du triage libère une part significative de ce temps pour des tâches à plus forte valeur ajoutée.
Trois capacités différencient les solutions actuelles des générations précédentes :
- La classification automatique par analyse du texte de la déclaration, qui attribue une priorité et un domaine (IT, sécurité, maintenance) sans intervention humaine.
- L’orchestration des intervenants avec notification ciblée selon des règles prédéfinies, y compris la gestion des astreintes et des remplacements.
- La génération assistée du rapport post-incident, qui synthétise la chronologie, les actions menées et les recommandations à partir des données du ticket.
Critères de choix d’un logiciel de gestion des incidents adapté à votre entreprise
Le choix d’une solution dépend moins du nombre de fonctionnalités affichées que de l’adéquation avec le processus réel de l’entreprise. Un outil surconfiguré que personne n’utilise coûte plus cher qu’un outil simple adopté par tous.
- La facilité de déclaration pour les non-techniciens : si le formulaire demande plus de deux minutes, le taux de signalement chute. L’accès mobile est un prérequis, pas un bonus.
- La couverture du cycle complet : de la déclaration à la revue post-incident, en passant par l’escalade et le suivi des actions correctives. Un outil qui s’arrête à la clôture du ticket laisse un angle mort sur la prévention.
- L’intégration avec les outils existants (messagerie, SIRH, supervision technique) : chaque ressaisie manuelle est une source d’erreur et de perte de temps.
- La conformité réglementaire native : horodatage, piste d’audit, conservation des preuves. Ces fonctions doivent être intégrées par défaut, pas ajoutées en surcouche.
QHSE et IT : des besoins convergents
Les équipes QHSE (qualité, hygiène, sécurité, environnement) et les équipes IT partagent un besoin identique : transformer chaque incident en donnée exploitable pour réduire la récurrence. La différence réside dans le vocabulaire et les référentiels. Un bon logiciel de gestion des incidents propose des modèles de formulaires adaptés à chaque domaine tout en alimentant un référentiel commun d’analyse.
La convergence entre ces deux mondes est accélérée par les exigences de NIS2 et des normes ISO. Les entreprises qui gèrent encore leurs incidents QHSE sur papier et leurs incidents IT sur Jira perdent la vision transversale nécessaire pour identifier les problèmes systémiques. Un référentiel unique d’incidents améliore la détection des causes profondes partagées entre domaines, comme un défaut de maintenance qui génère à la fois un incident de sécurité physique et une panne d’équipement connecté.